


Von Jon Fleetwood
Erkennen wir Viren oder uns selbst?
Der „Influenza SARS-CoV-2 (Flu SC2) Multiplex Assay” der CDC ist ein Echtzeit-Reverse-Transkriptase-Polymerase-Kettenreaktionstest (rRT-PCR), der zum Nachweis von Influenza A, Influenza B und SARS-CoV-2 in Proben aus den oberen oder unteren Atemwegen verwendet wird.
Die gängigen Gesundheitsbehörden verwenden PCR-Tests, um die Anzahl der Infektionsfälle zu quantifizieren.
Die Fallzahlen werden verwendet, um Pandemien auszurufen und Pandemie-Maßnahmen wie Lockdowns, Maskenpflicht, soziale Distanzierung und Impfkampagnen zu rechtfertigen.
Was aber, wenn diese Tests keine Viren nachweisen?
Was wäre, wenn sie menschliche DNA nachweisen?
Das würde bedeuten, dass die primäre Rechtfertigung für Pandemieerklärungen auf Signalen basiert, die möglicherweise gar keine Virusinfektion darstellen, sondern amplifizierte Fragmente des menschlichen Genoms – was die wissenschaftliche Grundlage für Fallzahlen, Notstandsbefugnisse und alle damit verbundenen politischen Entscheidungen in Frage stellt.
Angesichts der hohen Wahrscheinlichkeit einer bevorstehenden Vogelgrippe-Pandemie und der auf dieser Website dokumentierten internationalen Koordination ist eine genaue Überprüfung des PCR-Tests gerechtfertigt.
Eine neue BLAST-Analyse des Influenza SARS-CoV-2 (Flu SC2) Multiplex Assay der CDC zeigt, dass jede Variante des Influenza-A-Forward-Primers, des Reverse-Primers (über alle Mehrdeutigkeitsauflösungen hinweg) und der Sonde unabhängig voneinander Dutzende bis über 100 signifikante Teilübereinstimmungen erzeugt – oft perfekt über 15–18 bp Kernsegmente – die über fast jedes menschliche Chromosom verstreut sind und eine weit verbreitete menschliche Genomhomologie begründen.
PCR-Test der CDC auf Influenza
Ein positives PCR-Testergebnis erfordert, dass das genetische Material in der Probe mit drei genetischen Sequenzen übereinstimmt: einer Vorwärtsprimer-Sequenz, einer Rückwärtsprimer-Sequenz und einer Zielsondensequenz.
(Während diese Bindungen in der richtigen Ausrichtung, im richtigen Abstand und in der richtigen Kombination vorliegen müssen, um unter den spezifischen Bedingungen des Tests ein nachweisbares Amplikon und ein Fluoreszenzsignal zu erzeugen, konzentriert sich das aktuelle Projekt nur auf die genetische Ausrichtung zwischen den PCR-Testprimern/-sonden und dem menschlichen Genom.
Die US-amerikanischen Zentren für Krankheitskontrolle und Prävention (CDC) geben die Primer- und Sondensequenzen für ihren „Influenza SARS-CoV-2 (Flu SC2) Multiplex Assay” bekannt, die unten mit roten Kästchen dargestellt sind, die den Vorwärtsprimer, den Rückwärtsprimer und die Sonde für Influenza A kennzeichnen.
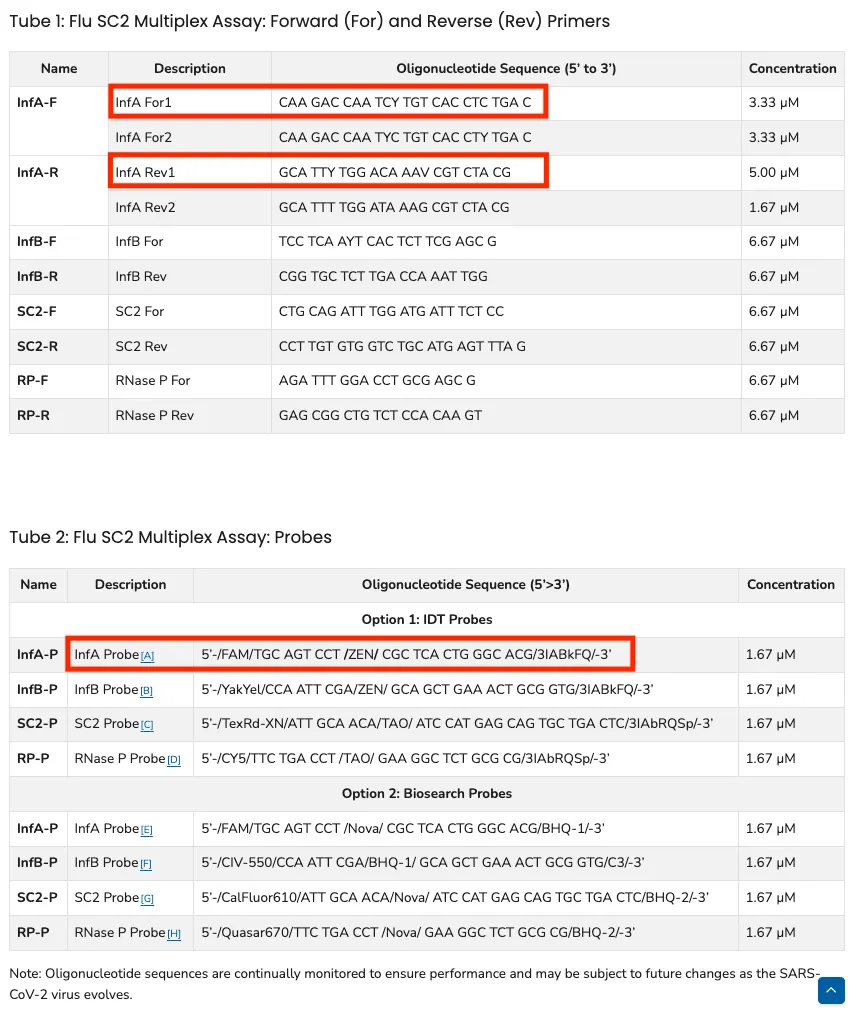
Auf dem obigen Screenshot ist zu sehen, dass Teile der Vorwärts- und Rückwärtsprimer an einigen Stellen ein „Y“ und „V“ anstelle der Standard-Nukleotidbuchstaben A, C, G oder T für DNA aufweisen.
Y und V sind IUPAC-Mehrdeutigkeitscodes, die es den Primern ermöglichen, sich an mehr als eine mögliche genetische Sequenz in einer Probe zu binden, wodurch der Bereich der DNA-Sequenzen, an die sich die Primer binden können, erheblich erweitert wird.
Dadurch entstehen mehr Wege, um ein positives PCR-Ergebnis zu erzielen.
Darüber hinaus können Primer auch dann an die Proben-DNA binden, wenn die Sequenzen nicht perfekt übereinstimmen, was wiederum die Anzahl der Wege zu einem positiven PCR-Ergebnis vervielfacht.
Y kann ein C oder T sein.
V kann ein A, C oder G sein.
Wir haben jede der folgenden Varianten getestet.
BLAST-Ergebnisse
Mithilfe der BLAST-Software (Basic Local Alignment Search Tool) der Regierung haben wir getestet, ob eine dieser drei PCR-Sequenzen, die zur Zählung von Influenza-A-Infektionen verwendet werden, mit einer menschlichen Genomsequenz übereinstimmt.
Ergebnisse des Vorwärtsprimers
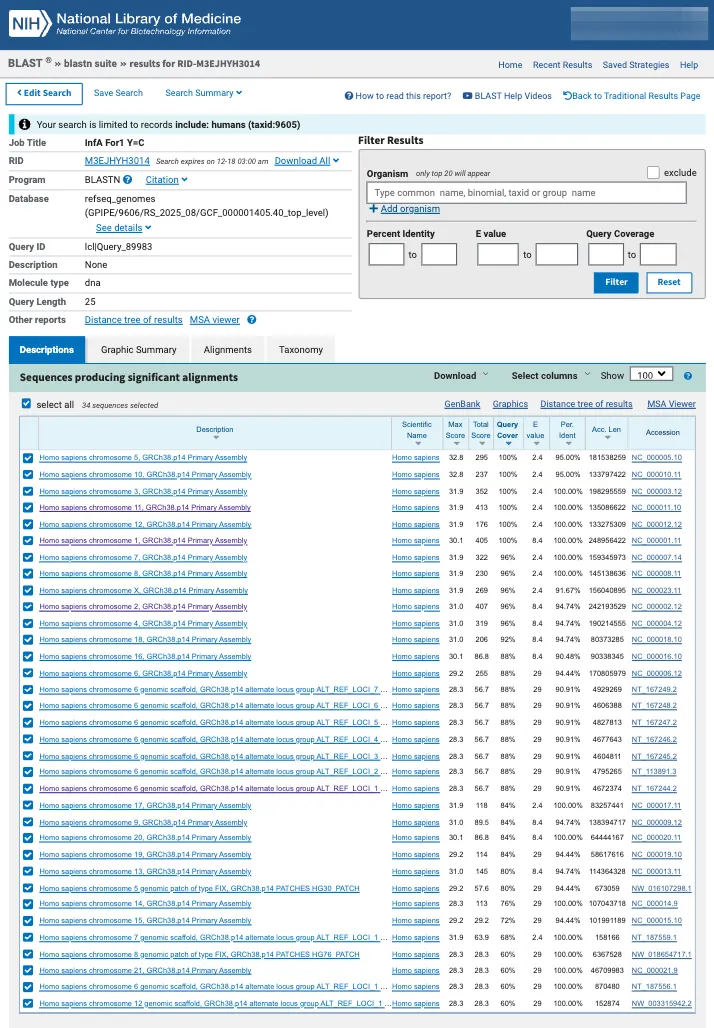
Y = C
Als wir den Mehrdeutigkeitscode Y des Vorwärtsprimers der CDC durch C ersetzten, zeigten die Ergebnisse, dass die Vorwärtsprimersequenz zahlreiche signifikante Alignments erzeugt, die über fast alle menschlichen Chromosomen verteilt sind, darunter die Chromosomen 1 bis 12, 14 bis 21, X und mehrere alternative Locus-Scaffolds und genomische Patches.
Die Übereinstimmungen mit den höchsten Werten erreichen 32,8 Bit mit einer Identität von 95–100 % und E-Werten von 2,4, vor allem auf den Chromosomen 5 und 10, während die meisten anderen Alignments eine Identität von 94–100 % über 15–23 Basen aufweisen, wobei viele kürzere Segmente perfekt übereinstimmen.
Insgesamt wurden mehr als 100 signifikante Treffer im gesamten Genom identifiziert.
Diese Ergebnisse deuten darauf hin, dass der Vorwärtsprimer (wenn Y=C) nicht nur für einen einzigen Locus spezifisch ist, sondern einem gemeinsamen Motiv oder einer sehr ähnlichen repetitiven Sequenz entspricht, die in mehreren Regionen des menschlichen Genoms vorkommt.
Y = T
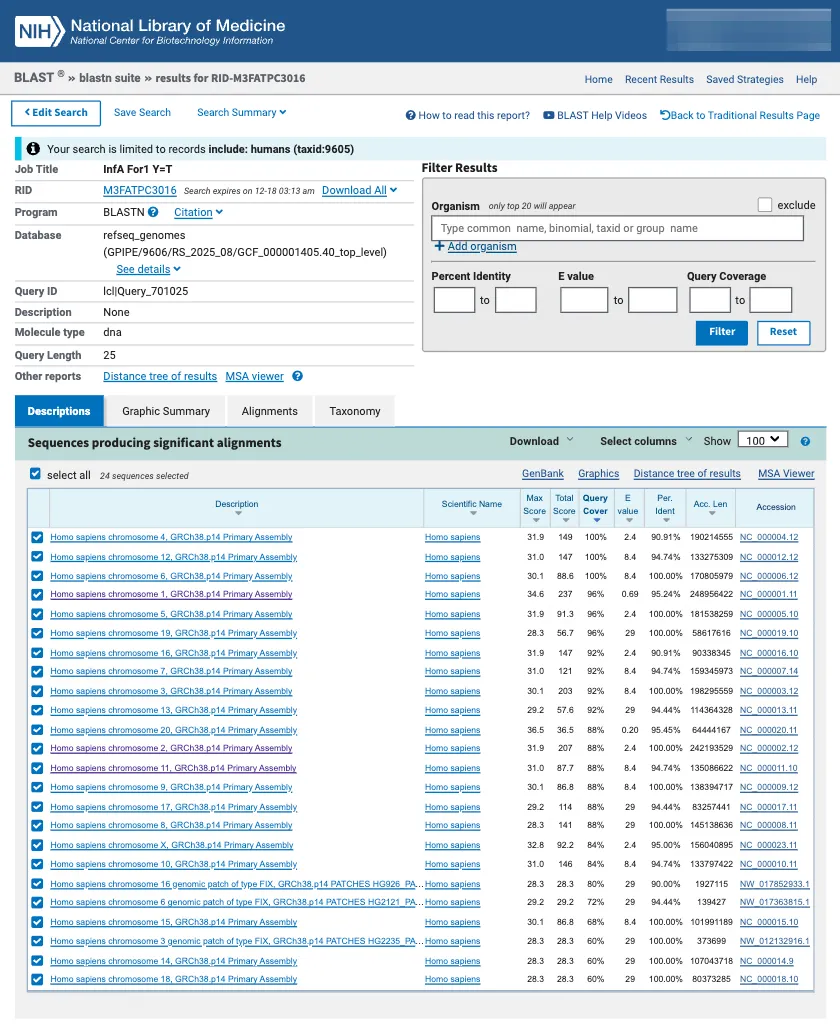
Als wir den Vorwärtsprimer Y-Mehrdeutigkeitscode der CDC durch T ersetzten, zeigten die Ergebnisse, dass die Primersequenz zahlreiche signifikante Alignments erzeugt, die über die meisten menschlichen Chromosomen verteilt sind, darunter die Chromosomen 1 bis 13, 15 bis 20, X und mehrere genomische Patches oder Scaffolds.
Die Übereinstimmung mit der höchsten Punktzahl erreicht einen Wert von 36,5 Bit mit einer Identität von 95,45 % und einem E-Wert von 0,20 auf Chromosom 20, während die meisten anderen Alignments eine Identität von 90–100 % über 15–23 Basen aufweisen, wobei viele kürzere Segmente nahezu perfekt übereinstimmen.
Insgesamt wurden Dutzende signifikanter Treffer im gesamten Genom identifiziert, mit mehreren übereinstimmenden Regionen pro Chromosom (z. B. bis zu 8 auf Chromosom 1).
Diese Ergebnisse deuten darauf hin, dass die Vorwärtsprimer-Sequenz (wenn Y=T) nicht einzigartig für einen einzelnen Locus ist, sondern einem gemeinsamen Motiv oder einem sehr ähnlichen repetitiven Element entspricht, das in verschiedenen Regionen des menschlichen Genoms vorkommt.
Ergebnisse des Reverse Primers
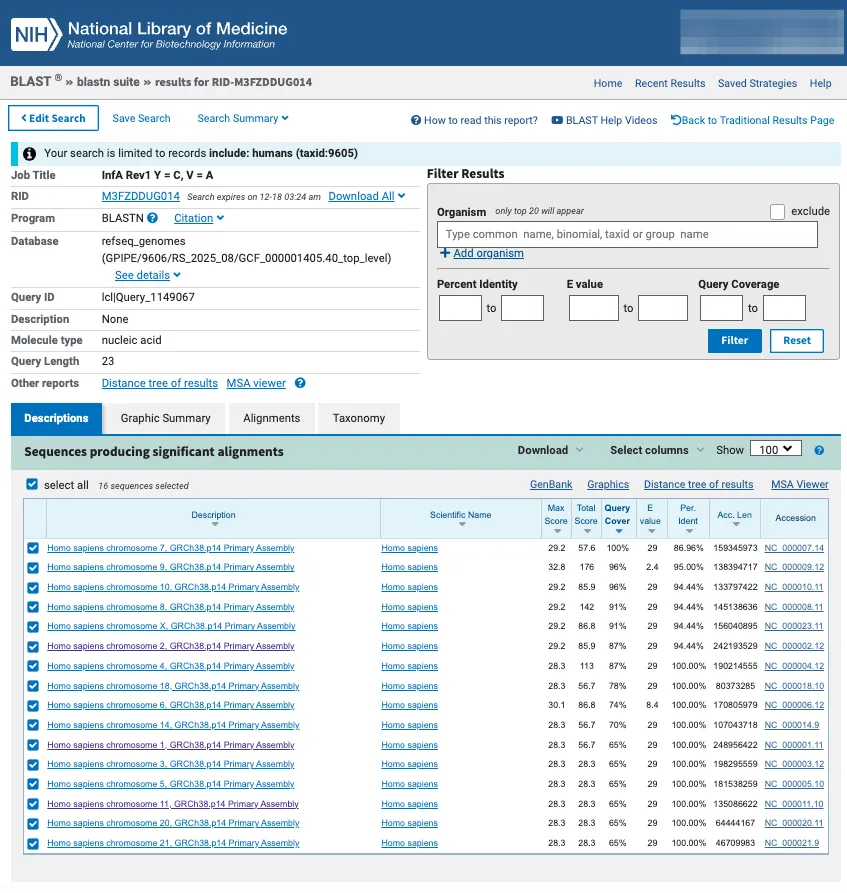
Y = C, V = A
Als wir den Ambiguitätscode Y des Reverse Primers der CDC durch C und den Ambiguitätscode V durch A ersetzten, zeigten die Ergebnisse, dass die Primersequenz signifikante Alignments erzeugt, die über mehrere menschliche Chromosomen verteilt sind, darunter die Chromosomen 1 bis 11, 14, 18, 20, 21 und X.
Die Übereinstimmung mit der höchsten Punktzahl erreicht einen Wert von 32,8 Bit mit einer Identität von 95 % bei einer Abdeckungsrate von 96 % und einem E-Wert von 2,4 auf Chromosom 9, während die meisten anderen Alignments eine Identität von 87–100 % über 15–20 Basen aufweisen, wobei viele kürzere Segmente perfekt übereinstimmen.
Insgesamt wurden genomweit etwa 30–40 signifikante Treffer identifiziert, mit mehreren übereinstimmenden Regionen pro Chromosom (z. B. bis zu 6 auf Chromosom 9).
Diese Ergebnisse deuten darauf hin, dass die Vorwärtssequenz (wenn Y = C, V = A) nicht einzigartig für einen einzelnen Locus ist, sondern einem gemeinsamen Motiv oder einem sehr ähnlichen repetitiven Element entspricht, das in verschiedenen Regionen des menschlichen Genoms vorkommt.
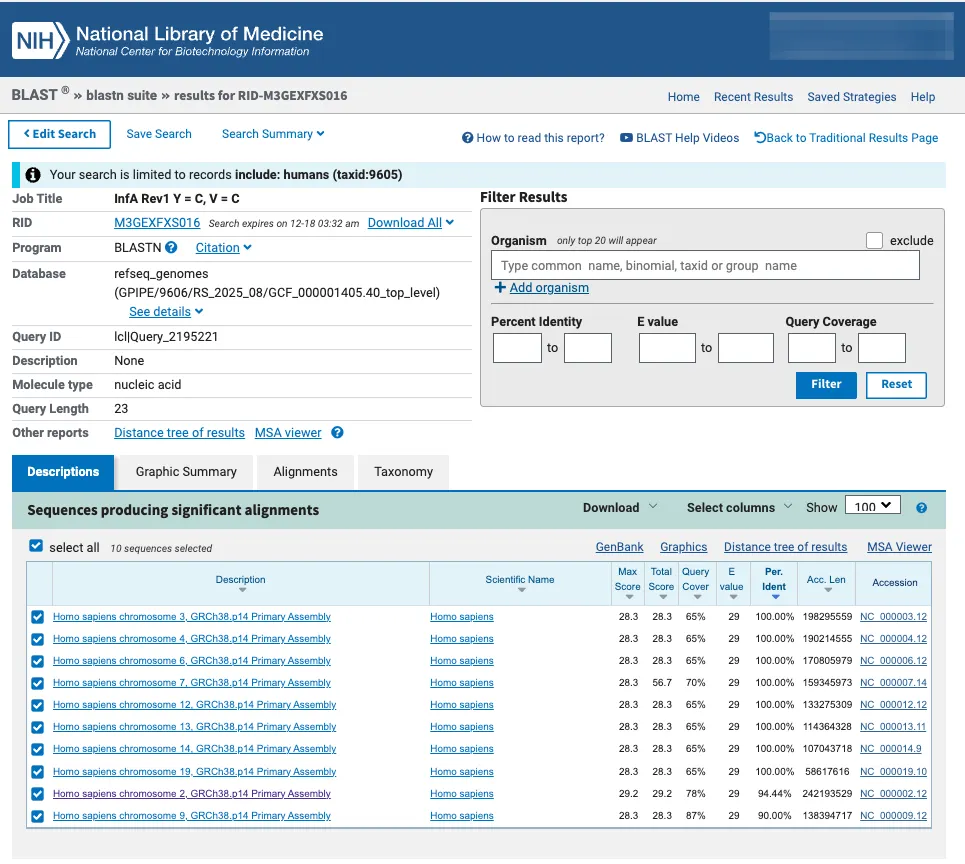
Y = C, V = C
Als wir den Reverse-Primer-Y-Mehrdeutigkeitscode des CDC durch C und den Mehrdeutigkeitscode V durch C ersetzten, zeigten die Ergebnisse signifikante Übereinstimmungen auf mehreren menschlichen Chromosomen, darunter die Chromosomen 2, 3, 4, 6, 7, 12, 13, 14 und 19, mit einem zusätzlichen Treffer mit geringerer Identität auf Chromosom 9.
Alle Top-Treffer haben Werte von 28,3–29,2 Bit und E-Werte von 29, die hauptsächlich aus perfekten 15/15-bp-Übereinstimmungen (100 % Identität) oder nahezu perfekten längeren Segmenten bestehen (z. B. 17/18 bei 94 % auf Chromosom 2 und 18/20 bei 90 % auf Chromosom 9).
Insgesamt wurden etwa 11 signifikante Treffer auf diesen Chromosomen identifiziert, wobei Chromosom 7 zwei separate Übereinstimmungen aufweist.
Diese Ergebnisse deuten darauf hin, dass die Reverse-Primer-Sequenz (wenn Y = C, V = C) nicht einzigartig für einen einzelnen Locus ist, sondern ein hochkonserviertes 15-bp-Kernmotiv aufweist, das in mehreren Regionen des menschlichen Genoms vorkommt, wobei die umgebenden Basen geringfügige Variationen aufweisen.
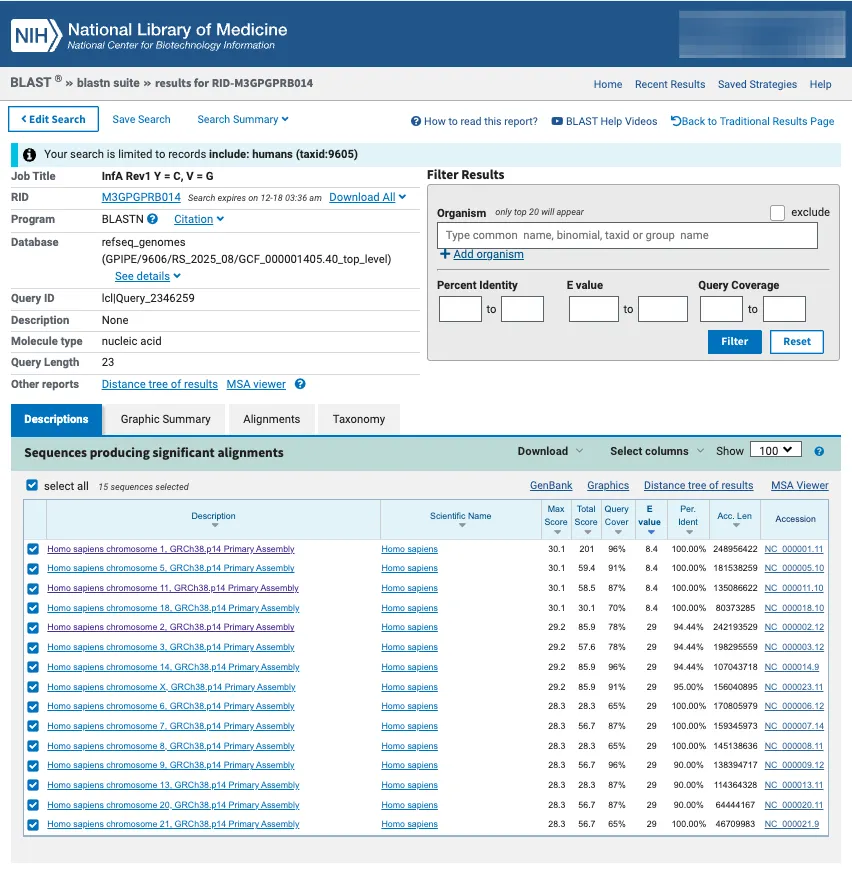
Y = C, V = G
Als wir den Reverse-Primer-Y-Mehrdeutigkeitscode der CDC durch C und den Mehrdeutigkeitscode V durch G ersetzten, zeigten die Ergebnisse signifikante Übereinstimmungen, die sich über mehrere menschliche Chromosomen verteilten, darunter die Chromosomen 1 bis 3, 5 bis 9, 11, 13, 14, 18, 20, 21 und X.
Die Übereinstimmungen mit den höchsten Werten erreichen 30,1 Bit mit einer Identität von 100 % bei einer Abdeckungsrate von 70–96 % und E-Werten von 8,4 (z. B. auf den Chromosomen 1, 5, 11 und 18), während die meisten anderen Übereinstimmungen eine Identität von 90–100 % über 15–20 Basen aufweisen, wobei viele kürzere Segmente perfekt übereinstimmen.
Insgesamt wurden genomweit etwa 30–40 signifikante Treffer identifiziert, mit mehreren übereinstimmenden Regionen pro Chromosom (z. B. bis zu 6 auf Chromosom 1).
Diese Ergebnisse deuten darauf hin, dass die Reverse-Primer-Sequenz (wenn Y = C, V = G) nicht einzigartig für einen einzelnen Locus ist, sondern einem gemeinsamen Motiv oder einem sehr ähnlichen repetitiven Element entspricht, das in verschiedenen Regionen des menschlichen Genoms vorkommt.
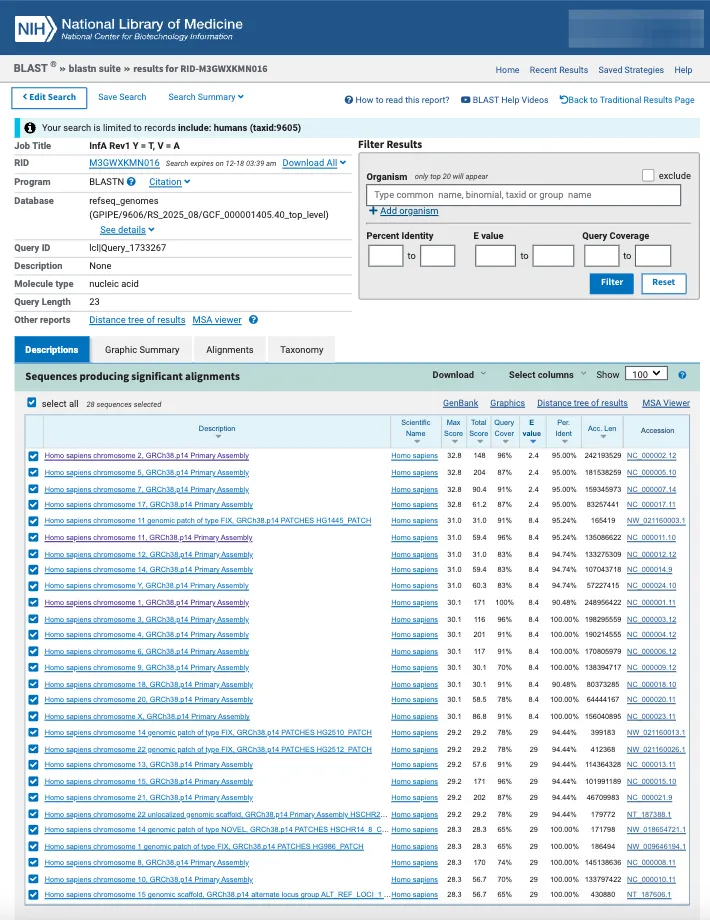
Y = T, V = A
Als wir den Reverse-Primer-Y-Mehrdeutigkeitscode der CDC für T und den Mehrdeutigkeitscode V für A ersetzten, zeigten die Ergebnisse, dass die Sequenz zahlreiche signifikante Alignments erzeugt, die über die meisten menschlichen Chromosomen verteilt sind, darunter die Chromosomen 1 bis 7, 9 bis 12, 14, 17, 18, 20, X und Y sowie mehrere genomische Patches und Scaffolds.
Die Übereinstimmungen mit den höchsten Werten erreichen 32,8 Bit mit einer Identität von 95 % bei einer Abdeckungsrate von 87–96 % und E-Werten von 2,4 (z. B. auf den Chromosomen 2, 5, 7 und 17), während die meisten anderen Alignments eine Identität von 90–100 % über 15–21 Basen aufweisen, wobei viele kürzere Segmente perfekt übereinstimmen.
Insgesamt wurden mehr als 50 signifikante Treffer im gesamten Genom identifiziert, mit mehreren übereinstimmenden Regionen pro Chromosom (z. B. bis zu 6 auf Chromosom 5 oder 8 auf Chromosom 8).
Diese Ergebnisse deuten darauf hin, dass die Reverse-Primer-Sequenz (wenn Y = T, V = A) nicht einzigartig für einen einzelnen Locus ist, sondern einem gemeinsamen Motiv oder einem sehr ähnlichen repetitiven Element entspricht, das in verschiedenen Regionen des menschlichen Genoms vorkommt.
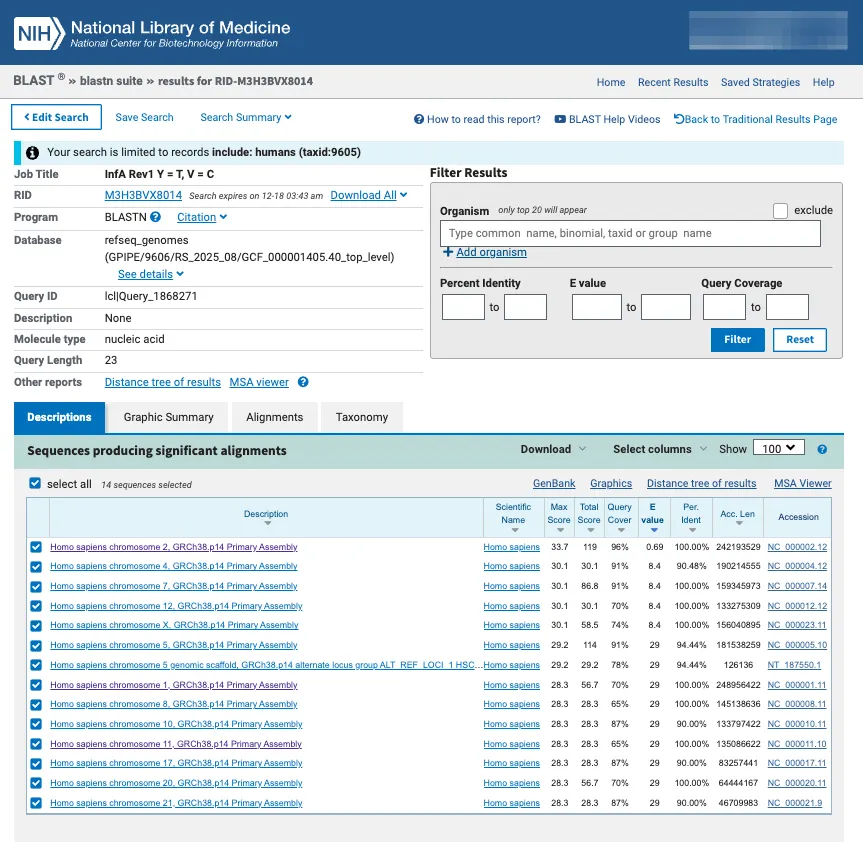
Y = T, V = C
Als wir den Reverse-Primer-Y-Mehrdeutigkeitscode der CDC durch T und den Mehrdeutigkeitscode V durch C ersetzten, zeigten die Ergebnisse signifikante Übereinstimmungen, die sich über mehrere menschliche Chromosomen verteilten, darunter die Chromosomen 1, 2, 4, 5, 7, 8, 10, 11, 12, 17, 20, 21 und X sowie ein alternatives Gerüst auf Chromosom 5.
Die Übereinstimmung mit der höchsten Punktzahl erreicht einen Wert von 33,7 Bit mit einer Identität von 100 % bei einer Abdeckungsrate von 96 % und einem E-Wert von 0,69 auf Chromosom 2, während die meisten anderen Übereinstimmungen eine Identität von 90–100 % über 15–20 Basen aufweisen, wobei viele kürzere Segmente perfekt oder nahezu perfekt übereinstimmen.
Insgesamt wurden genomweit etwa 20–30 signifikante Treffer identifiziert, mit mehreren übereinstimmenden Regionen pro Chromosom (z. B. bis zu 4 auf Chromosom 2).
Diese Ergebnisse deuten darauf hin, dass die Reverse-Primer-Sequenz (wenn Y = T, V = C) nicht einzigartig für einen einzelnen Locus ist, sondern einem gemeinsamen Motiv oder einem sehr ähnlichen repetitiven Element entspricht, das in verschiedenen Regionen des menschlichen Genoms vorkommt.
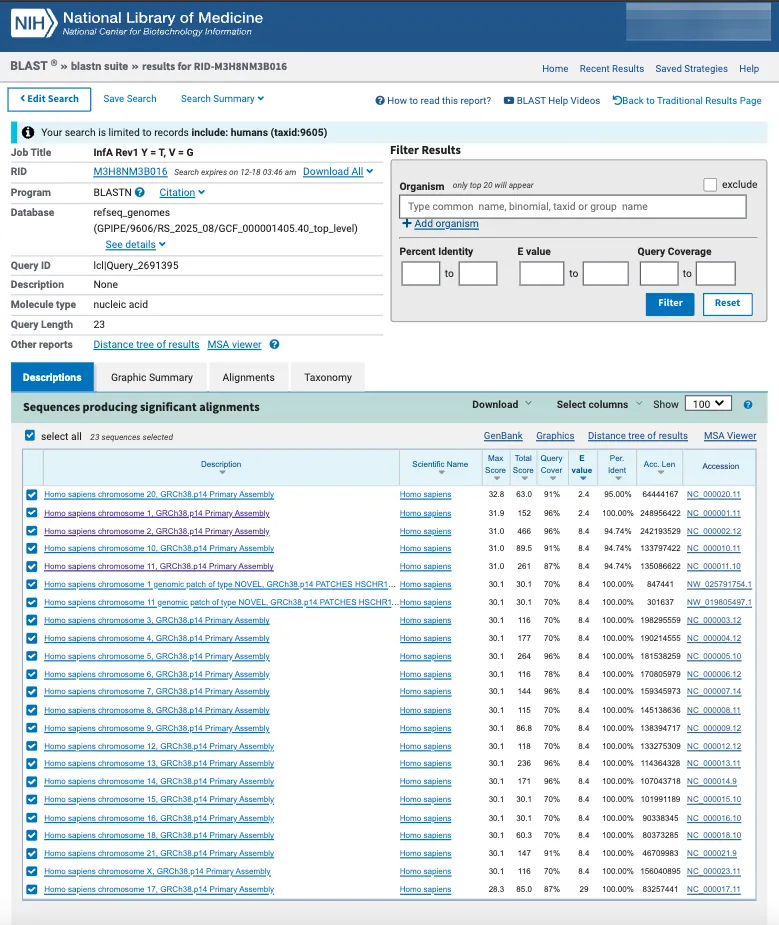
Y = T, V = G
Als wir den Reverse-Primer-Y-Mehrdeutigkeitscode der CDC für T und den Mehrdeutigkeitscode V für G ersetzten, zeigten die Ergebnisse, dass die Sequenz zahlreiche signifikante Alignments erzeugt, die über die meisten menschlichen Chromosomen verteilt sind, darunter die Chromosomen 1 bis 12, 14 bis 18, 20 bis 22, X und Y sowie mehrere genomische Patches und Scaffolds.
Die Übereinstimmung mit der höchsten Punktzahl erreicht einen Wert von 32,8 Bit mit einer Identität von 95 % bei einer Abdeckungsrate von 91 % und einem E-Wert von 2,4 auf Chromosom 20, während die meisten anderen Alignments eine Identität von 94,74–100 % über 16–21 Basen aufweisen, wobei viele kürzere Segmente perfekt übereinstimmen.
Insgesamt wurden mehr als 60 signifikante Treffer im gesamten Genom identifiziert, mit mehreren übereinstimmenden Regionen pro Chromosom (z. B. bis zu 8 auf Chromosom 2 oder 5 auf Chromosom 21).
Diese Ergebnisse deuten darauf hin, dass die Reverse-Primer-Sequenz (wenn Y = T, V = G) nicht einzigartig für einen einzelnen Locus ist, sondern einem gemeinsamen Motiv oder einem sehr ähnlichen repetitiven Element entspricht, das in verschiedenen Regionen des menschlichen Genoms vorkommt.
Probenergebnisse
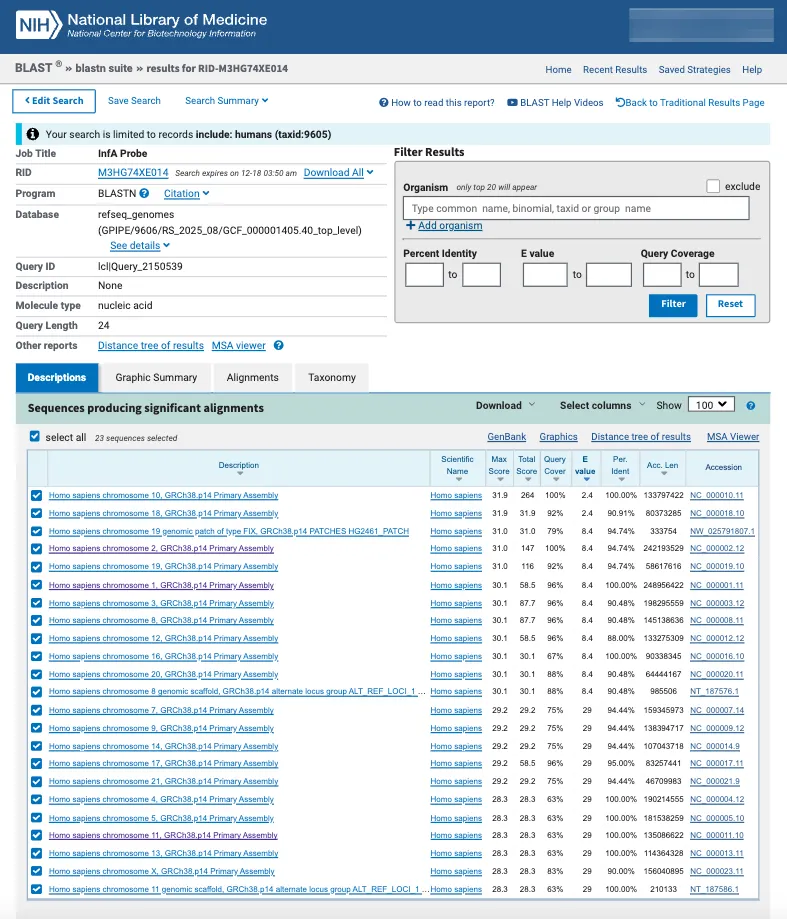
Bei der Ausrichtung der CDC-PCR-Testprobensequenz auf das menschliche Genom zeigen die Ergebnisse, dass die Sequenz zahlreiche signifikante Übereinstimmungen aufweist, die über die meisten menschlichen Chromosomen verteilt sind, darunter die Chromosomen 1 bis 5, 7 bis 14, 16 bis 21 und X sowie mehrere genomische Patches und Scaffolds.
Die Übereinstimmungen mit den höchsten Werten erreichen Werte von 31,9 Bit mit einer Identität von 90,91–100 % bei einer Abdeckungsrate von 92–100 % und E-Werten von 2,4 (z. B. auf den Chromosomen 10 und 18), während die meisten anderen Alignments eine Identität von 88–100 % über 15–23 Basen aufweisen, wobei viele kürzere Segmente perfekt oder nahezu perfekt übereinstimmen.
Insgesamt wurden genomweit etwa 40–50 signifikante Treffer identifiziert, mit mehreren übereinstimmenden Regionen pro Chromosom (z. B. bis zu 9 auf Chromosom 10).
Diese Ergebnisse deuten darauf hin, dass die Sondensequenz nicht nur an einem einzigen Locus vorkommt, sondern einem gemeinsamen Motiv oder einem sehr ähnlichen repetitiven Element entspricht, das in verschiedenen Regionen des menschlichen Genoms vorhanden ist.
Fazit
Jede getestete Variante des CDC-Influenza-A-Forward-Primers (sowohl Y=C- als auch Y=T-Auflösungen), des Reverse-Primers (alle sechs Y/V-Kombinationen) und der Sonde selbst weist unabhängig voneinander Dutzende bis über 100 signifikante Teilalignments (oft perfekt über 15–18 bp Kernsegmente) auf, die weit über das menschliche Genom auf fast jedem Chromosom verstreut sind.
Dies sind keine seltenen oder isolierten Treffer – es handelt sich um häufige, sich wiederholende Muster für jede Sequenz des Influenza-A-PCR-Tests der CDC.
Die schiere Anzahl und Verteilung dieser starken Übereinstimmungen über alle drei Komponenten hinweg bedeutet, dass es grundsätzlich viele Regionen des menschlichen Genoms gibt, an denen einer oder mehrere der PCR-Primer und die Sonde mit hoher Affinität binden könnten.
Ob diese Bindungen jemals in der richtigen Ausrichtung, im richtigen Abstand und in der richtigen Kombination ausgerichtet sind, um unter den spezifischen Bedingungen des Tests ein nachweisbares Amplikon und ein Fluoreszenzsignal zu erzeugen, ist eine offene empirische Frage, die allein mit diesen BLAST-Daten nicht vollständig geklärt werden kann.
Die Daten belegen jedoch eine nicht unerhebliche Überlappung der Sequenzen zwischen dem gesamten Influenza-A-PCR-Primer-/Proben-Set und weit verbreiteten menschlichen Genom-Motiven.
Diese Überlappung ist real, in unseren BLAST-Suchen dokumentiert und von nicht unerheblichem Ausmaß.
Sie rechtfertigt eine genaue Untersuchung, wie spezifisch der Assay tatsächlich für das genetische Material des Influenza-A-Virus im Vergleich zum potenziellen Hintergrund aus menschlicher DNA in Atemwegsproben ist, insbesondere bei hohen Zyklusschwellenwerten oder in sogenannten Szenarien mit geringer Viruslast.
Die Beweise zeigen ein klares und wiederholtes Muster der Homologie des menschlichen Genoms im gesamten Influenza-A-Nachweissystem.
Dieses Muster ist für sich genommen eine Erkenntnis, die ernsthaft berücksichtigt werden sollte.
Insbesondere, weil die bevorstehende Vogelgrippe-Pandemie auf PCR-Tests angewiesen sein wird, um die Fallzahlen zu rechtfertigen.


